什么是 Robots.txt?
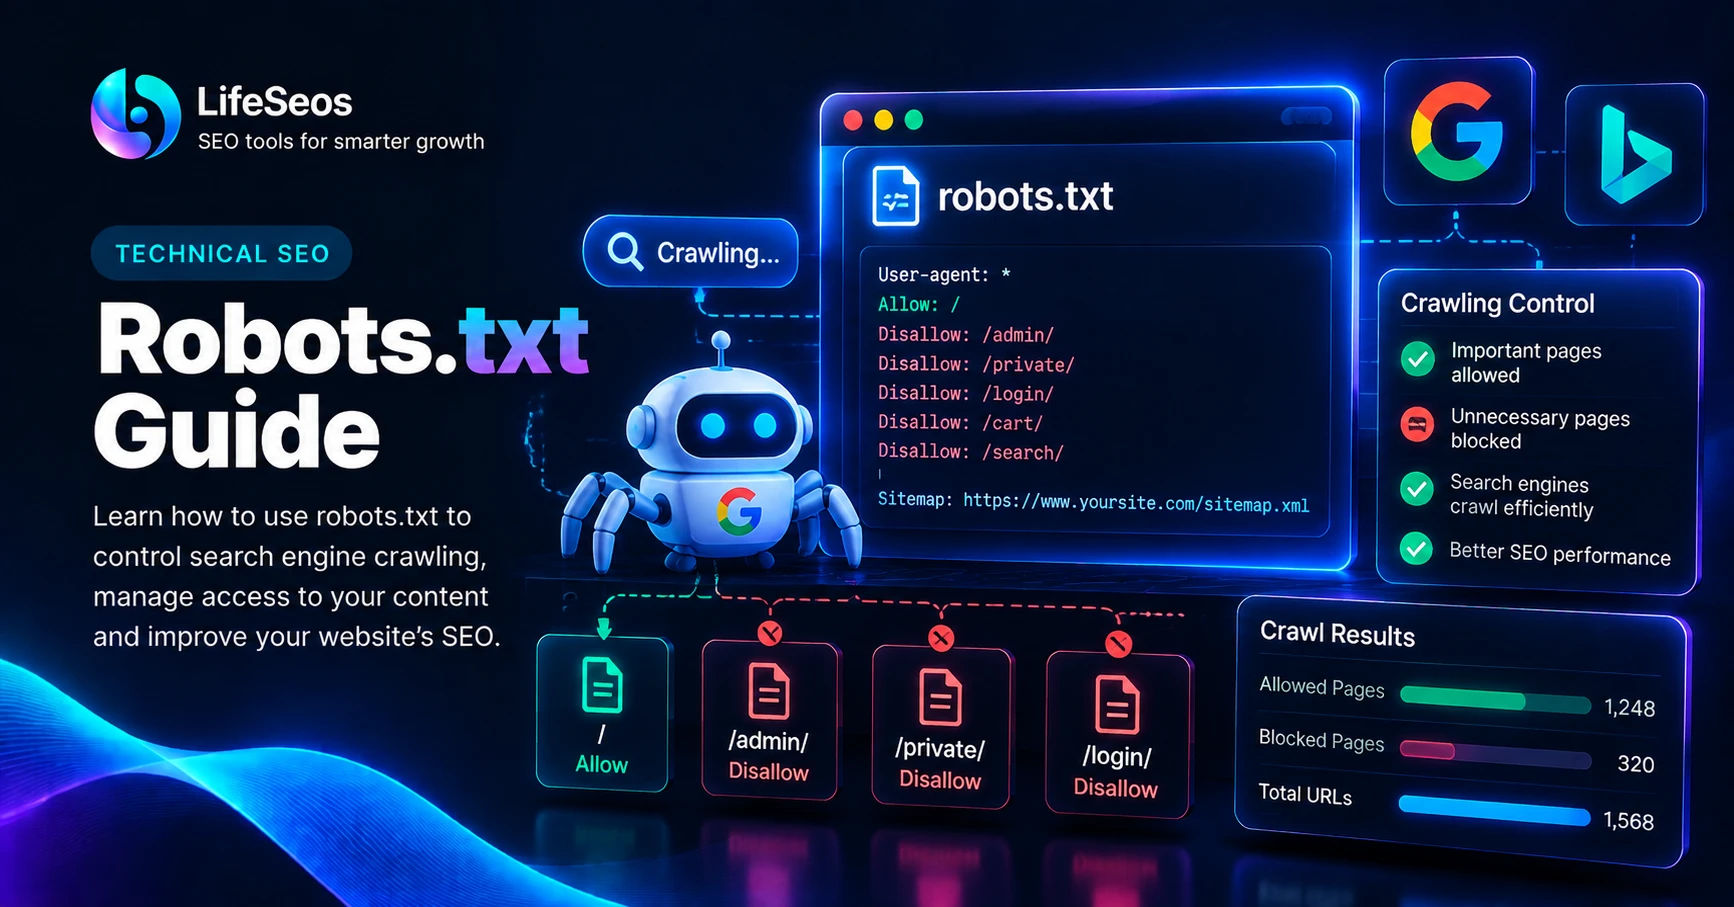
robots.txt 是一个纯文本文件,用于向受支持的搜索引擎爬虫及其他自动化爬虫提供抓取指令。
它通常放在网站根目录下,例如 yourdomain.com/robots.txt,这样爬虫在请求网站其他资源之前就能先读取这个文件。
借助这个文件,可以允许或限制爬虫访问网站的特定路径、目录或版块。
robots.txt 本质上是一个抓取管理工具,不应被当作安全防护手段,也不应被视为把页面从搜索结果中移除的可靠办法。
- 控制爬虫对网站路径的访问
- 使用简单的文本指令
- 可以针对特定爬虫
- 可以引用 XML 网站地图
- 支持抓取管理
- 无法保护私密信息
Robots.txt 文件位于哪里?
robots.txt 文件通常应能从网站根目录访问。
例如,如果你的网站是 https://example.com,那么 robots.txt 文件一般位于 https://example.com/robots.txt。
把文件放在其他目录里,无法提供同样的全站抓取指令。
该文件还应无需登录、也没有多余重定向即可访问。
- 使用根域名下的位置
- 确保文件可以公开加载
- 避免要求身份验证
- 使用稳定的 URL
- 在托管或路由发生重大变更后检查该文件
Robots.txt 是如何工作的?
当受支持的爬虫访问网站时,它会请求 robots.txt,并解读适用于自身 user agent 的规则。
规则通常按 user agent 分组,可以包含 Allow 和 Disallow 指令。
一条规则可以适用于所有受支持的爬虫,也可以只适用于某个特定爬虫。
由于不同爬虫对不受支持的指令可能有不同的解读方式,请保持文件简单,只依赖有明确文档说明的规则。
- User-agent 用于标识爬虫
- Disallow 限制对匹配路径的抓取
- Allow 可以放行更具体的路径
- Sitemap 可以引用 XML 网站地图的位置
- 规则由兼容的爬虫进行判断
理解 User-agent 指令
User-agent 指令用于指明一组 robots.txt 规则适用于哪个爬虫。
星号可以代表所有兼容的爬虫;如果某条规则只应适用于某个特定爬虫,也可以直接写该爬虫的名称。
大多数网站使用一条简单的通用规则就够了,除非有明确理由需要对某个特定爬虫区别对待。
避免创建不必要的爬虫专用规则,因为它们会让文件更难审阅。
- User-agent: * —— 适用于所有受支持的爬虫
- 不同的特定 user agent 可以各自拥有独立规则
- 通用规则保持简单
- 避免不必要的爬虫专用配置
Allow 与 Disallow 规则
Disallow 规则告知受支持的爬虫,哪些匹配路径不应被抓取。
在爬虫支持的前提下,Allow 规则可以用于放行某个受限版块中更具体的路径。
规则里的路径非常关键,一个小失误就可能屏蔽掉比预期更多的内容。
把大范围规则发布到正式网站之前,务必先确认它的实际影响。
- Disallow: /private/ —— 限制抓取匹配的目录
- Disallow: / —— 可能屏蔽整个网站的抓取
- Allow 规则可以创建特定的例外
- 大范围规则应仔细审核
- 路径匹配应在部署前进行测试
把 XML 网站地图添加到 Robots.txt
robots.txt 里可以写入 XML 网站地图的位置。
这为兼容的爬虫提供了另一条发现网站地图 URL 的途径。
网站地图本身仍应可公开访问,并包含准确的 canonical URL。
在 robots.txt 中引用网站地图,并不能取代通过搜索引擎站长工具提交网站地图。
- 使用完整的网站地图 URL
- 使用首选的 HTTPS 版本
- 确保网站地图能成功加载
- 保持网站地图位置准确
- 在适当情况下另外单独提交网站地图
为什么 Robots.txt 对 SEO 很重要?
robots.txt 会影响搜索引擎爬虫把时间花在网站不同区域上的方式。
对许多小型网站来说,抓取管理很简单,因为大多数公开页面本就应保持可访问。
较大的网站可能会用 robots.txt 来减少对低价值技术类 URL、筛选参数或重复资源路径的抓取。
最需要警惕的 SEO 问题,是误屏蔽了有价值的内容。
- 帮助管理爬虫的访问
- 可以减少不必要的抓取
- 有助于形成更清晰的技术配置
- 可以引用 XML 网站地图
- 有助于避免抓取某些技术类路径
- 需要细心维护
Robots.txt 与 Noindex 的区别
robots.txt 和 noindex 解决的是不同的问题,不应混为一谈。
robots.txt 控制受支持的爬虫是否可以访问某个 URL 或路径。
noindex 指令则是在搜索引擎能够访问并处理该指令之后,要求不要将页面纳入搜索结果。
如果在 robots.txt 中屏蔽了抓取,爬虫可能根本看不到页面自身设置的 noindex 指令。
- Robots.txt 控制抓取
- Noindex 控制索引行为
- 屏蔽抓取并不会自动把 URL 从搜索中移除
- 爬虫需要能够访问页面才能看到 noindex 指令
- 根据真实目标选择合适的方法
Robots.txt 不是安全工具
robots.txt 是公开可访问的,任何人打开该文件都能看到里面的规则。
它无法阻止他人直接访问某个 URL,而且并非所有自动化爬虫都必须遵守 robots.txt 的指令。
敏感资源应通过完善的身份验证、授权和服务器端访问控制来保护。
把私密路径写进 robots.txt,反而可能让人更容易注意到这条路径。
- 不要在 robots.txt 中存放密钥或机密
- 不要依赖 robots.txt 做访问控制
- 用身份验证保护私密页面
- 为敏感资源使用服务器端权限控制
- 记住该文件本身是公开的
常见的 Robots.txt 错误
robots.txt 文件通常很短,但小错误也可能带来很大影响。
最严重的错误,往往是误屏蔽了重要页面,或者误以为抓取限制能带来安全保障或索引控制。
在网站大规模迁移、路由调整或框架升级之后,要重新检查这个文件。
- 不小心屏蔽了整个网站
- 屏蔽了重要的公开页面
- 使用了错误的路径规则
- 把 robots.txt 当作安全机制
- 以为被屏蔽的页面不会出现在搜索结果中
- 使用已过期的网站地图 URL
- 添加了不必要的复杂规则
- 网站变更后忘记复查规则
一个简单的 Robots.txt 示例
对于一个公开的小型网站来说,基础的 robots.txt 配置通常就够了。
例如,你可以允许正常抓取,同时限制内部应用区域,并引用 XML 网站地图。
具体规则始终应与网站的真实结构相符,而不是从其他域名直接照搬。
- User-agent: *
- Disallow: /admin/
- Disallow: /api/
- Sitemap: https://example.com/sitemap.xml
如何测试 Robots.txt 的改动
每一次重要的 robots.txt 改动,都应当包含测试环节。
发布新规则之前,先明确哪些 URL 应保持可抓取、哪些 URL 应被限制。
部署之后,直接打开 robots.txt 文件,确认线上版本包含了你预期的规则。
在重要更新之后,关注搜索引擎的抓取和索引报告,留意异常变化。
- 发布前先审核规则
- 测试重要 URL
- 确认线上 robots.txt 文件的内容
- 检查网站地图引用
- 关注搜索引擎报告
- 排查异常的索引变化
现代框架中的 Robots.txt
许多现代网站框架可以自动生成 robots.txt,而不必手工维护一个文本文件。
当路由或环境发生变化时,这能减少维护工作,但生成出来的结果仍应经过审核。
例如,正式环境可以允许抓取公开内容,同时限制后台管理、身份验证或 API 路由。
用什么方式生成 robots.txt 并不重要,关键是最终对外公开的文件里是否有准确的规则。
- 静态 robots.txt 文件维护起来很简单
- 框架生成的文件可以自动更新
- 在生产环境中审核生成结果
- 必要时把开发环境与生产环境的规则分开
- 仔细核对被限制的路径
一套实用的 Robots.txt 工作流程
一套简单的流程有助于降低误屏蔽爬虫的风险。
首先明确网站里哪些版块应保持公开、哪些技术区域确实不需要抓取。
让文件保持精简,测试规则,并在部署后复核线上结果。
- 第 1 步 —— 列出重要的公开页面
- 第 2 步 —— 找出可能不需要抓取的技术路径
- 第 3 步 —— 编写简单的 User-agent 和 Disallow 规则
- 第 4 步 —— 添加网站地图 URL
- 第 5 步 —— 检查是否存在范围过大的误屏蔽
- 第 6 步 —— 测试重要 URL
- 第 7 步 —— 发布文件
- 第 8 步 —— 复核线上 robots.txt
- 第 9 步 —— 监控抓取和索引报告
Robots.txt SEO 最终检查清单
配置得当的 robots.txt 文件,能在不干扰重要公开内容的前提下帮助管理爬虫访问。
这个文件应保持简单、准确,并与网站当前的结构保持一致。
每当发生重大路由、迁移或索引变更时,都要复查 robots.txt。
- robots.txt 文件可公开访问
- 重要的公开页面未被屏蔽
- 已审核范围过大的 Disallow 规则
- 私密内容使用了真正的访问控制
- 没有把 robots.txt 当作 noindex 的替代方案
- 网站地图 URL 正确
- 规则与当前网站结构相符
- 已测试生产环境的输出
- 网站发生重大变更后会复查该文件
把这篇文章用起来
打开对应的 LifeSeos 工具,把刚学到的内容应用到自己的网站上。
Robots.txt 生成器