Qu’est-ce que le robots.txt ?
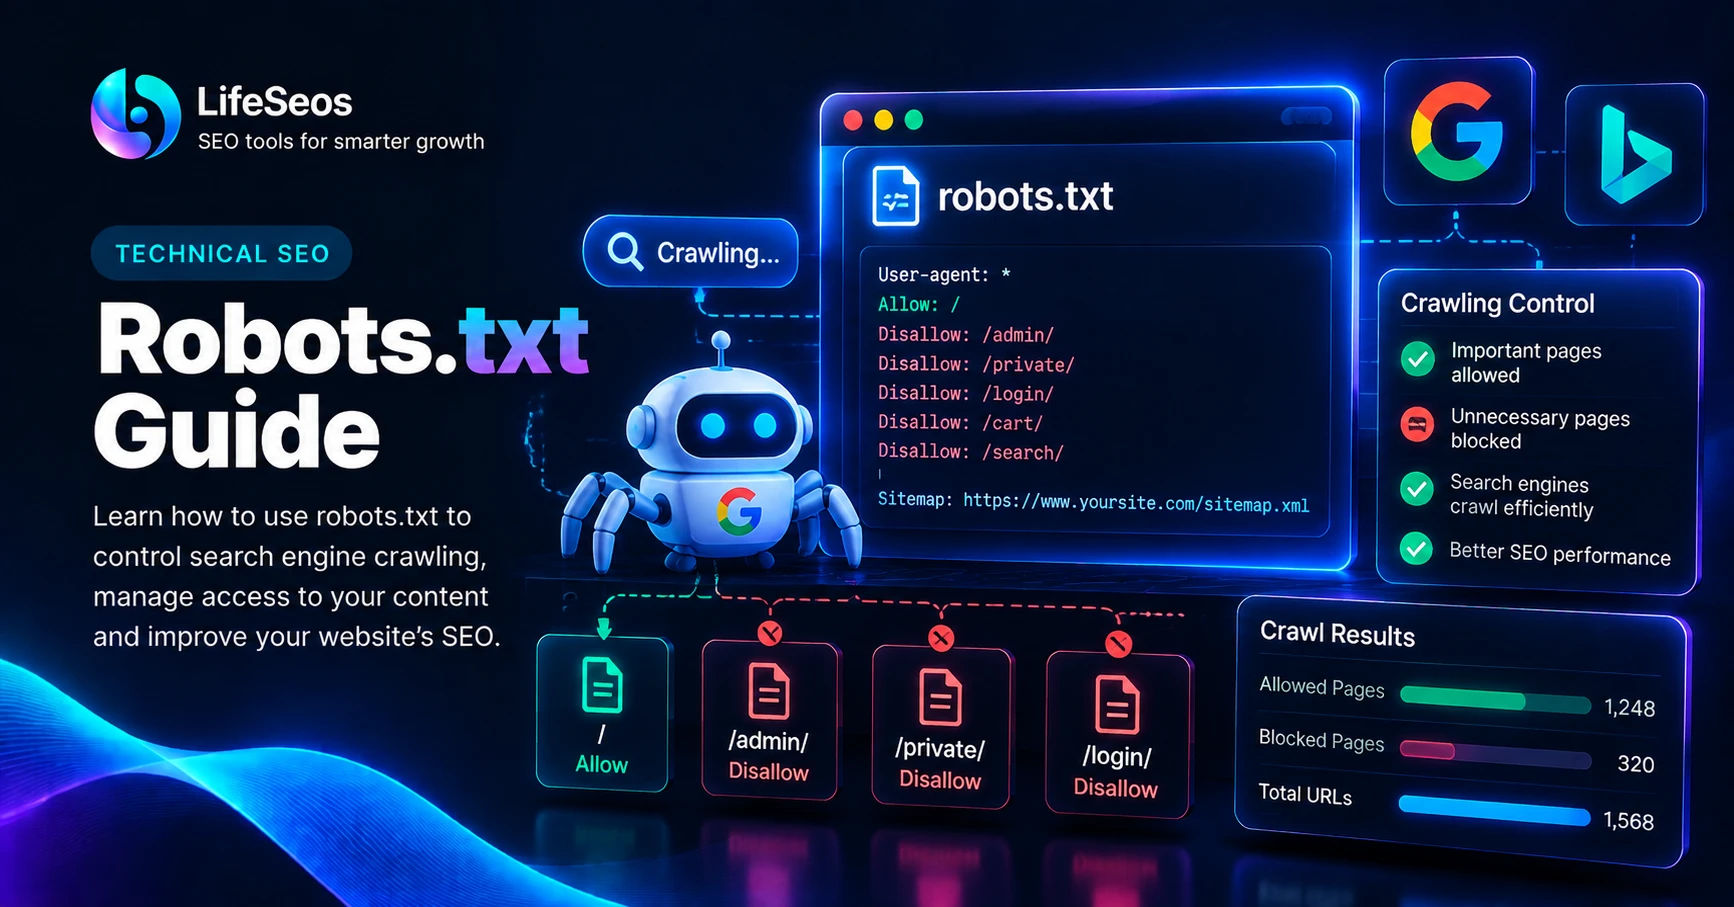
Le robots.txt est un fichier texte brut qui fournit des instructions d’exploration aux robots des moteurs de recherche compatibles et aux autres robots d’exploration automatisés.
Il est généralement placé à la racine d’un site, par exemple yourdomain.com/robots.txt, afin que les robots d’exploration puissent consulter le fichier avant de demander d’autres ressources du site.
Ce fichier permet d’autoriser ou de restreindre l’accès des robots d’exploration à certains chemins, dossiers ou sections d’un site.
Le robots.txt est avant tout un outil de gestion de l’exploration. Il ne doit pas être considéré comme une mesure de sécurité ni comme une méthode fiable pour retirer des pages des résultats de recherche.
- Contrôle l’accès des robots d’exploration aux chemins du site
- Repose sur des directives textuelles simples
- Peut cibler des robots spécifiques
- Peut référencer un sitemap XML
- Facilite la gestion de l’exploration
- Ne protège pas les informations privées
Où se trouve le fichier robots.txt ?
Le fichier robots.txt doit normalement être accessible à la racine du site.
Par exemple, si votre site est https://example.com, le fichier robots.txt sera généralement disponible à l’adresse https://example.com/robots.txt.
Placer le fichier dans un autre dossier ne fournit pas les mêmes instructions d’exploration à l’échelle du site.
Le fichier doit également être accessible sans authentification ni redirections inutiles.
- Utilisez l’emplacement à la racine du domaine
- Vérifiez que le fichier est accessible publiquement
- Évitez d’exiger une authentification
- Utilisez une URL stable
- Contrôlez le fichier après tout changement important d’hébergement ou de routage
Comment fonctionne le robots.txt ?
Lorsqu’un robot d’exploration compatible visite un site, il peut demander le robots.txt et interpréter les règles qui s’appliquent à son agent utilisateur.
Les règles sont généralement regroupées par agent utilisateur et peuvent inclure les directives Allow et Disallow.
Une règle peut s’appliquer à tous les robots compatibles ou uniquement à un robot spécifique.
Comme différents robots peuvent interpréter différemment les directives non prises en charge, gardez le fichier simple et appuyez-vous sur les règles documentées.
- User-agent identifie le robot d’exploration
- Disallow restreint l’exploration des chemins correspondants
- Allow peut autoriser un chemin plus spécifique
- Sitemap peut référencer l’emplacement du sitemap XML
- Les règles sont évaluées par les robots compatibles
Comprendre la directive User-agent
La directive User-agent indique à quel robot s’applique un ensemble de règles robots.txt.
Un astérisque peut représenter tous les robots compatibles, tandis qu’un nom de robot spécifique peut être utilisé lorsqu’une règle ne doit s’appliquer qu’à ce robot.
La plupart des sites peuvent se contenter d’une règle générale simple, sauf s’il existe une raison claire de traiter un robot spécifique différemment.
Évitez de créer des règles spécifiques inutiles, car elles rendent le fichier plus difficile à vérifier.
- User-agent: * — s’applique à tous les robots compatibles
- Des agents utilisateur spécifiques peuvent avoir des règles distinctes
- Gardez les règles générales simples
- Évitez les configurations spécifiques inutiles par robot
Les règles Allow et Disallow
Les règles Disallow indiquent aux robots compatibles quels chemins correspondants ne doivent pas être explorés.
Les règles Allow peuvent autoriser un chemin plus spécifique au sein d’une section autrement restreinte, lorsque le robot le prend en charge.
Le chemin indiqué dans la règle est déterminant. Une petite erreur peut bloquer plus de contenu que prévu.
Vérifiez toujours l’effet des règles étendues avant de les publier sur un site en production.
- Disallow: /private/ — restreint l’exploration du dossier correspondant
- Disallow: / — peut bloquer l’exploration de tout le site
- Les règles Allow peuvent créer des exceptions spécifiques
- Les règles étendues doivent être vérifiées avec attention
- La correspondance des chemins doit être testée avant le déploiement
Ajouter votre sitemap XML au robots.txt
Le robots.txt peut inclure l’emplacement de votre sitemap XML.
Cela offre aux robots compatibles un autre moyen de découvrir l’URL du sitemap.
Le sitemap doit malgré tout être accessible publiquement et contenir des URL canoniques exactes.
Référencer un sitemap dans le robots.txt ne remplace pas son envoi via les outils pour webmasters des moteurs de recherche.
- Utilisez l’URL complète du sitemap
- Utilisez la version HTTPS privilégiée
- Vérifiez que le sitemap se charge correctement
- Maintenez l’emplacement du sitemap à jour
- Envoyez le sitemap séparément lorsque c’est pertinent
Pourquoi le robots.txt est-il important pour le SEO ?
Le robots.txt peut influencer la manière dont les robots des moteurs de recherche répartissent leur temps entre les différentes zones d’un site.
Pour de nombreux petits sites, la gestion de l’exploration est simple, car la plupart des pages publiques doivent rester accessibles.
Les sites plus volumineux peuvent utiliser le robots.txt pour réduire l’exploration d’URL techniques de faible valeur, de filtres ou de chemins de ressources répétés.
Le principal enjeu SEO est d’éviter de bloquer par erreur du contenu important.
- Aide à gérer l’accès des robots d’exploration
- Peut réduire l’exploration inutile
- Favorise une configuration technique plus propre
- Peut référencer le sitemap XML
- Aide à éviter l’exploration de certains chemins techniques
- Exige une maintenance attentive
Robots.txt et noindex : quelle différence ?
Le robots.txt et la directive noindex répondent à des problèmes différents et ne doivent pas être confondus.
Le robots.txt contrôle si un robot compatible peut accéder à une URL ou à un chemin.
Une directive noindex demande qu’une page ne soit pas incluse dans les résultats de recherche, une fois que le moteur de recherche a pu accéder à la directive et la traiter.
Si l’exploration est bloquée dans le robots.txt, le robot peut ne pas voir une directive noindex placée sur la page elle-même.
- Le robots.txt contrôle l’exploration
- Noindex contrôle le comportement d’indexation
- Bloquer l’exploration ne retire pas automatiquement une URL des résultats de recherche
- Un robot peut avoir besoin d’accéder à la page pour voir une directive noindex
- Choisissez la méthode en fonction de l’objectif réel
Le robots.txt n’est pas un outil de sécurité
Le robots.txt est accessible publiquement et ses règles sont visibles par quiconque ouvre le fichier.
Il n’empêche pas une personne de visiter une URL directement, et tous les robots automatisés ne sont pas tenus de respecter les instructions du robots.txt.
Les ressources sensibles doivent être protégées par une authentification, une autorisation et des contrôles d’accès côté serveur adaptés.
Lister un chemin privé dans le robots.txt peut même le rendre plus facile à repérer.
- Ne stockez pas de secrets dans le robots.txt
- Ne comptez pas sur le robots.txt pour le contrôle d’accès
- Protégez les pages privées par une authentification
- Utilisez des permissions côté serveur pour les ressources sensibles
- Gardez à l’esprit que le fichier lui-même est public
Les erreurs courantes avec le robots.txt
Les fichiers robots.txt sont généralement courts, mais de petites erreurs peuvent avoir des conséquences importantes.
Les erreurs les plus graves consistent à bloquer par inadvertance des pages importantes ou à croire que les restrictions d’exploration assurent la sécurité ou le contrôle de l’indexation.
Vérifiez le fichier après toute migration importante, modification de routage ou mise à jour de framework.
- Bloquer tout le site par accident
- Bloquer des pages publiques importantes
- Utiliser des règles de chemin incorrectes
- Utiliser le robots.txt comme mécanisme de sécurité
- Croire que les pages bloquées ne peuvent pas apparaître dans les résultats
- Utiliser des URL de sitemap obsolètes
- Ajouter des règles complexes inutiles
- Oublier de vérifier les règles après une modification du site
Un exemple simple de robots.txt
Une configuration robots.txt de base suffit souvent pour un petit site public.
Par exemple, vous pouvez autoriser l’exploration normale tout en restreignant les zones d’application internes et en référençant le sitemap XML.
Les règles exactes doivent toujours correspondre à la structure réelle du site, et non être copiées aveuglément depuis un autre domaine.
- User-agent: *
- Disallow: /admin/
- Disallow: /api/
- Sitemap: https://example.com/sitemap.xml
Comment tester les modifications du robots.txt
Les tests doivent faire partie de toute modification importante du robots.txt.
Avant de publier une nouvelle règle, identifiez les URL qui doivent rester explorables et celles qui doivent être restreintes.
Après le déploiement, ouvrez directement le fichier robots.txt et vérifiez que la version en production contient bien les règles prévues.
Surveillez les rapports d’exploration et d’indexation des moteurs de recherche pour détecter tout changement inattendu après une mise à jour importante.
- Vérifiez la règle avant de la publier
- Testez les URL importantes
- Confirmez le contenu du fichier robots.txt en production
- Contrôlez les références au sitemap
- Surveillez les rapports des moteurs de recherche
- Analysez tout changement d’indexation inattendu
Le robots.txt avec les frameworks modernes
De nombreux frameworks web modernes peuvent générer automatiquement le robots.txt au lieu d’exiger un fichier texte maintenu à la main.
Cela réduit la maintenance lorsque les routes ou les environnements changent, mais le résultat généré doit tout de même être vérifié.
Par exemple, un site en production peut autoriser le contenu public tout en restreignant les routes d’administration, d’authentification ou d’API.
La méthode utilisée pour générer le robots.txt importe moins que la présence de règles exactes dans le fichier public final.
- Les fichiers robots.txt statiques sont simples à maintenir
- Les fichiers générés par le framework peuvent se mettre à jour automatiquement
- Vérifiez le résultat généré en production
- Séparez les règles de développement et de production lorsque c’est nécessaire
- Vérifiez attentivement les chemins restreints
Un processus pratique pour le robots.txt
Un processus simple permet de réduire le risque de blocage accidentel des robots d’exploration.
Commencez par identifier les sections du site qui doivent rester publiques et les zones techniques qui n’ont réellement pas besoin d’être explorées.
Gardez le fichier minimal, testez les règles et vérifiez le résultat en production après le déploiement.
- Étape 1 — Listez les pages publiques importantes
- Étape 2 — Identifiez les chemins techniques qui n’ont pas besoin d’être explorés
- Étape 3 — Créez des règles User-agent et Disallow simples
- Étape 4 — Ajoutez l’URL du sitemap
- Étape 5 — Recherchez d’éventuels blocages étendus accidentels
- Étape 6 — Testez les URL importantes
- Étape 7 — Publiez le fichier
- Étape 8 — Vérifiez le robots.txt en ligne
- Étape 9 — Surveillez les rapports d’exploration et d’indexation
Checklist finale du robots.txt pour le SEO
Un fichier robots.txt bien configuré aide à gérer l’accès des robots d’exploration sans interférer avec le contenu public important.
Le fichier doit rester simple, exact et aligné sur la structure actuelle du site.
Vérifiez le robots.txt à chaque modification importante de routage, migration ou indexation.
- Le fichier robots.txt est accessible publiquement
- Les pages publiques importantes ne sont pas bloquées
- Les règles Disallow étendues ont été vérifiées
- Le contenu privé utilise de véritables contrôles d’accès
- Le robots.txt n’est pas utilisé comme substitut à noindex
- L’URL du sitemap est correcte
- Les règles correspondent à la structure actuelle du site
- Le résultat en production a été testé
- Le fichier est vérifié après toute modification importante du site
Mettez ce guide en pratique
Ouvrez l’outil LifeSeos associé et appliquez ce que vous venez d’apprendre à votre propre site.
Générateur de robots.txt